Tokeny AI to jednostki, w których model sztucznej inteligencji czyta i pisze tekst. Polska firma płaci za nie więcej niż amerykańska, bo ten sam tekst po polsku dzieli się na więcej tokenów. W moim teście różnica wynosiła od 36% do 77%, w zależności od modelu.
Cztery teksty firmowe po polsku i po angielsku policzyłem 29 października 2026 r. za pomocą ośmiu publicznych tokenizerów, od OpenAI po polskie modele Bielik i PLLuM.
Czym Są Tokeny AI?
Token to kawałek tekstu, który model AI traktuje jako jedną jednostkę. Tokeny mogą być całym słowem, jego częścią albo znakiem. Model nie widzi liter, tylko ciąg tokenów, i w tokenach liczy też długość odpowiedzi.
OpenAI podaje regułę dla angielskiego: 100 tokenów to około 75 słów. Ta sama strona zastrzega, że inne języki mają inną relację między znakami, słowami i tokenami.
Za podział odpowiada tokenizer, który ma stały słownik, od kilkudziesięciu do ponad 260 tysięcy pozycji. Każdy z modeli ma swój tokenizer, dlatego podział tekstu na tokeny wygląda w różnych narzędziach AI inaczej. Od liczby tokenów zależy cena korzystania z AI przez API. Specjalne tokeny model dodaje też na początku rozmowy, ale nie liczyłem ich w teście. Tokeny AI nie mają nic wspólnego z kryptowalutami.
Dlaczego Polski Tekst Zużywa Więcej Tokenów?
Polski tekst zużywa więcej tokenów, bo rzadsze słowa zostają podzielone na mniejsze części. Tokenizer łączy w jeden token ciągi znaków, które często widzi w danych. Im mniej polskiego w tych danych, tym częściej polskie słowo rozpada się na kawałki.
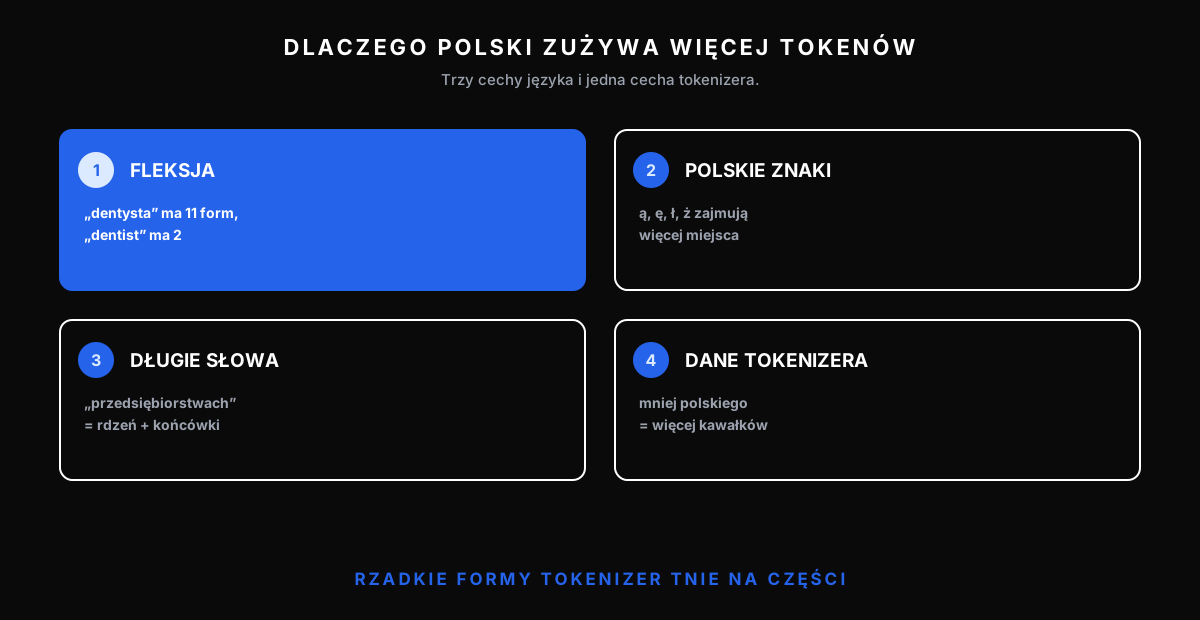
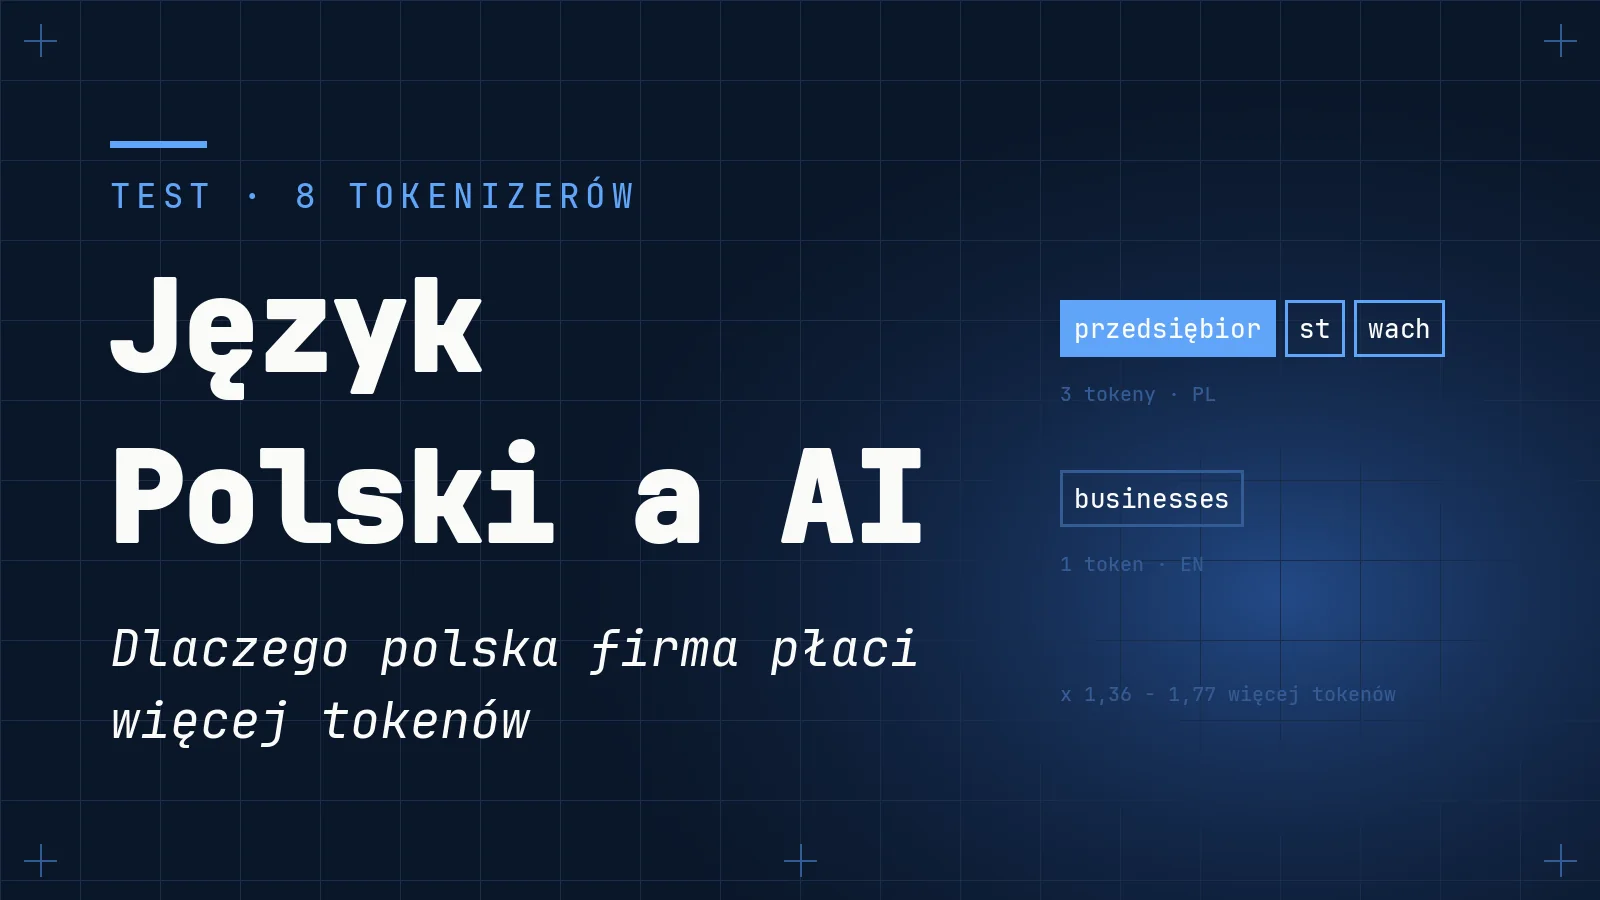
Główną przyczyną jest fleksja. Angielski „dentist” ma dwie formy, a polski „dentysta” jedenaście, od „dentysty” po „dentystach”. Tokenizer nie zmieści w słowniku każdej formy, więc zapisuje rdzeń w jednym tokenie, a końcówkę w drugim. Dochodzą do tego polskie znaki, które zajmują w zapisie więcej miejsca, i długie słowa. „Przedsiębiorstwach” to rdzeń, przyrostek i końcówka, a angielskie „businesses” każdy tokenizer w teście zapisał jednym tokenem.
Jak Tokenizer Dzieli Polskie Słowa na Tokeny?
Tokenizer dzieli polskie słowa na rdzeń i końcówkę albo na kilka krótszych kawałków, a angielskie najczęściej zostawia w całości. Nawet zwykłe słowa mogą zostać podzielone na kilka tokenów: w tokenizerze GPT-4o „zarezerwować” to 4 tokeny, a „book” jeden.
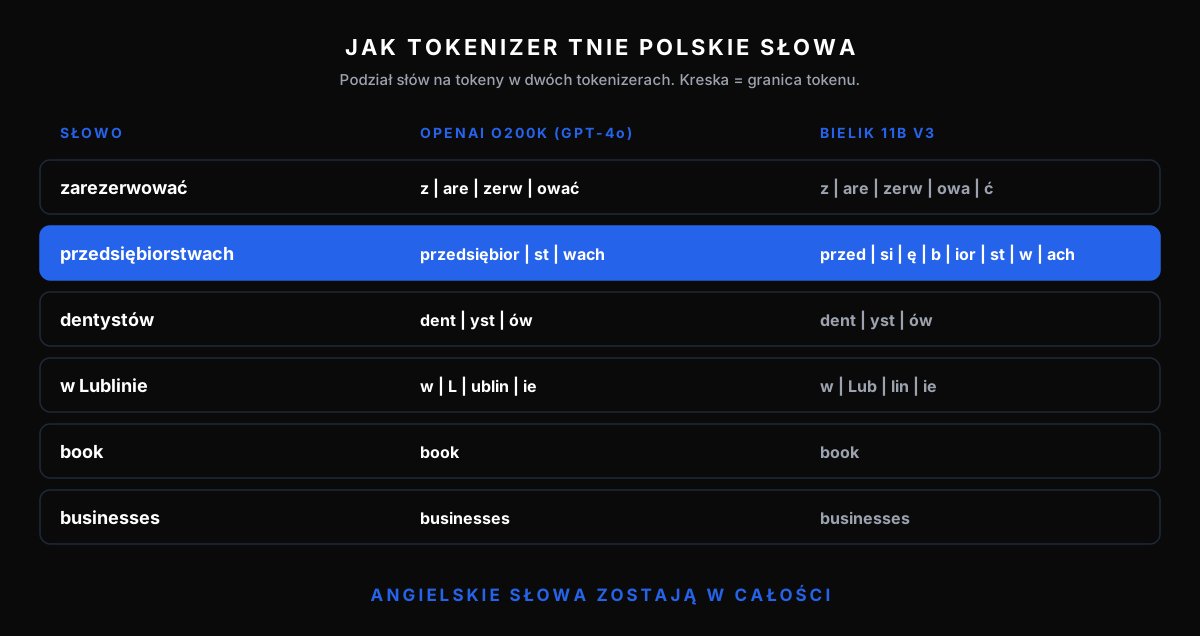
„W Lublinie” w tokenizerze OpenAI to cztery tokeny: „w”, „L”, „ublin” i „ie”. W Bieliku 11B v3 „przedsiębiorstwach” rozpadło się nawet na 8 kawałków, a w tokenizerach OpenAI o200k_base i Gemma 3 zajęło tylko 3. Ta sama cecha języka sprawia, że klienci wpisują w Google różne formy jednej frazy, na przykład „dentysta lublin” i „dentysta w lublinie”.
Ile Więcej Tokenów Potrzebuje Polski Tekst?
Polski tekst potrzebował od 1,36 do 1,77 razy więcej tokenów niż ten sam tekst w języku angielskim. Przewaga angielskiego wystąpiła w każdym z 8 tokenizerów i w każdym z 4 typów tekstu.
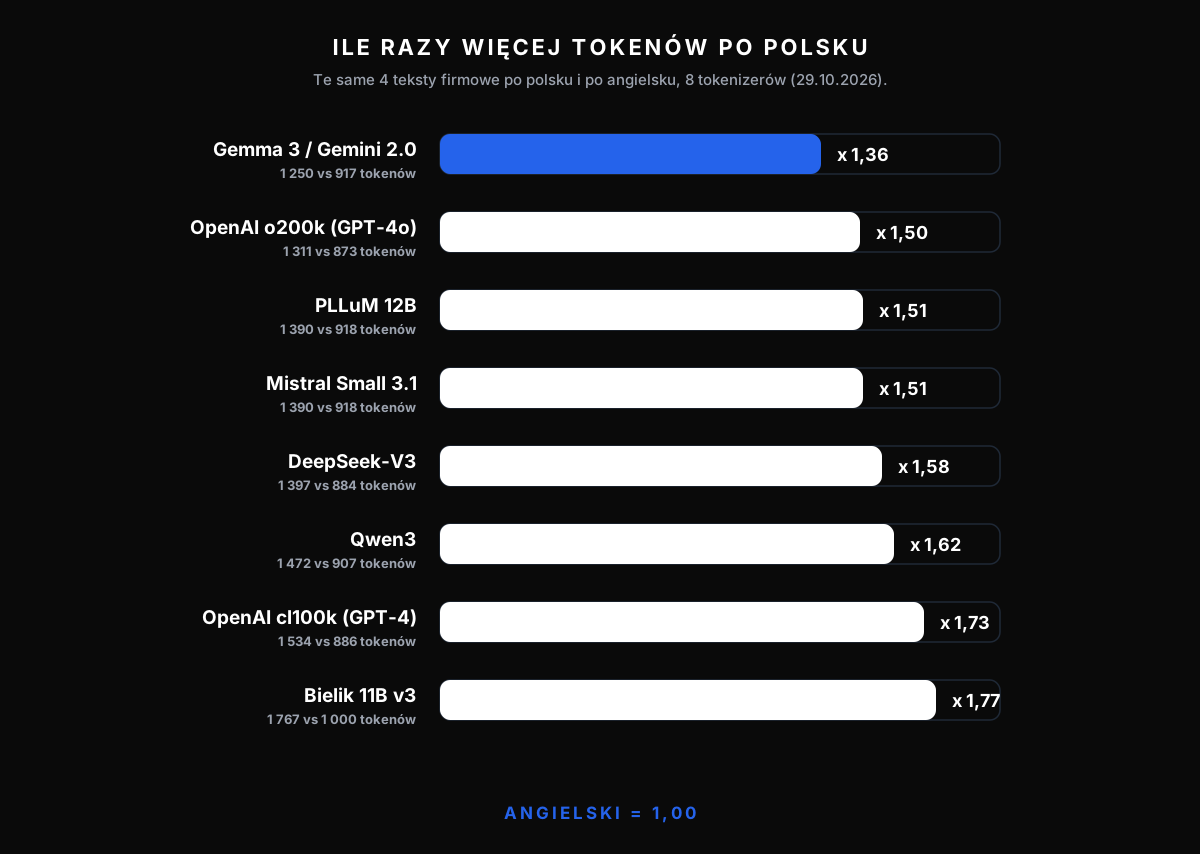
Najlepiej wypadł tokenizer Gemma 3: 1 250 tokenów wobec 917, czyli 1,36 raza więcej. Według raportu technicznego Gemma 3 z marca 2025 r. to ten sam tokenizer co w Gemini 2.0, lepiej zrównoważony dla języków innych niż angielski.
Tokenizer OpenAI o200k_base, używany od GPT-4o, potrzebował 1,50 raza więcej, a starszy cl100k_base z GPT-4 1,73 raza. Najwięcej zużył polski Bielik 11B v3: 1,77 raza. Szerzej o tych modelach piszę w tekście o tym, czym są Bielik i PLLuM.
PLLuM 12B i Mistral Small 3.1 podzieliły wszystkie osiem tekstów na dokładnie te same tokeny.
Czy Rodzaj Tekstu Zmienia Liczbę Tokenów?
Rodzaj tekstu zmienia liczbę tokenów mniej niż wybór modelu. Opis usługi, opis produktu, e-mail do klienta i klauzula RODO dały w tokenizerze GPT-4o od 1,46 do 1,53 raza więcej tokenów po polsku.
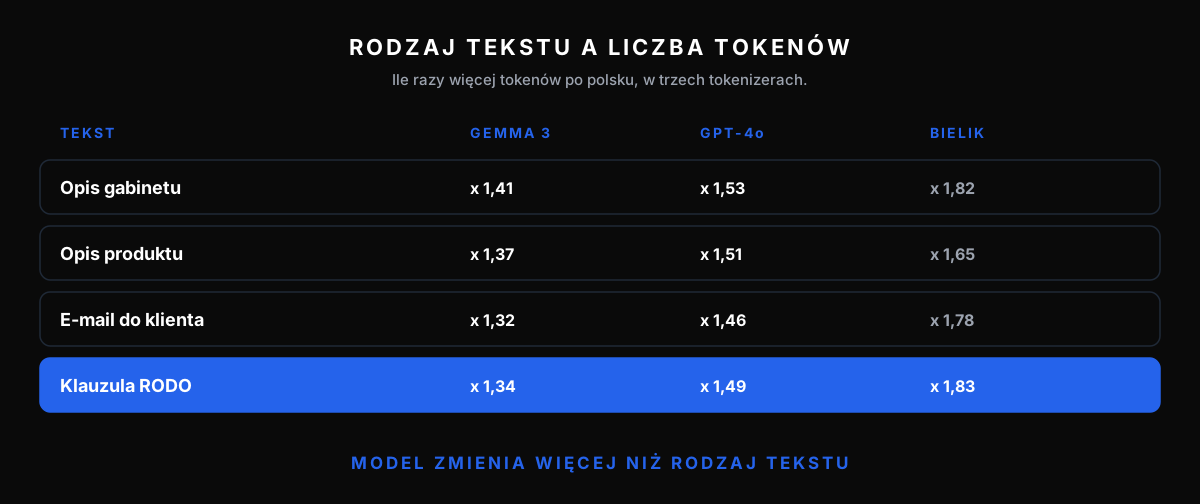
Najmniejszą różnicę miał prosty e-mail do klienta. W Bieliku najgorzej wypadł tekst prawniczy: 1,83 raza więcej, bo długie słowa, takie jak „niezbędność”, mały słownik dzieli na wiele części.
Jak Słownik Tokenizera Wpływa na Polski?
Większy słownik tokenizera zwykle oznacza mniej tokenów na polski tekst. Gemma 3 z 262 145 pozycjami zużyła najmniej, a Bielik 11B v3 z 32 128 pozycjami najwięcej.
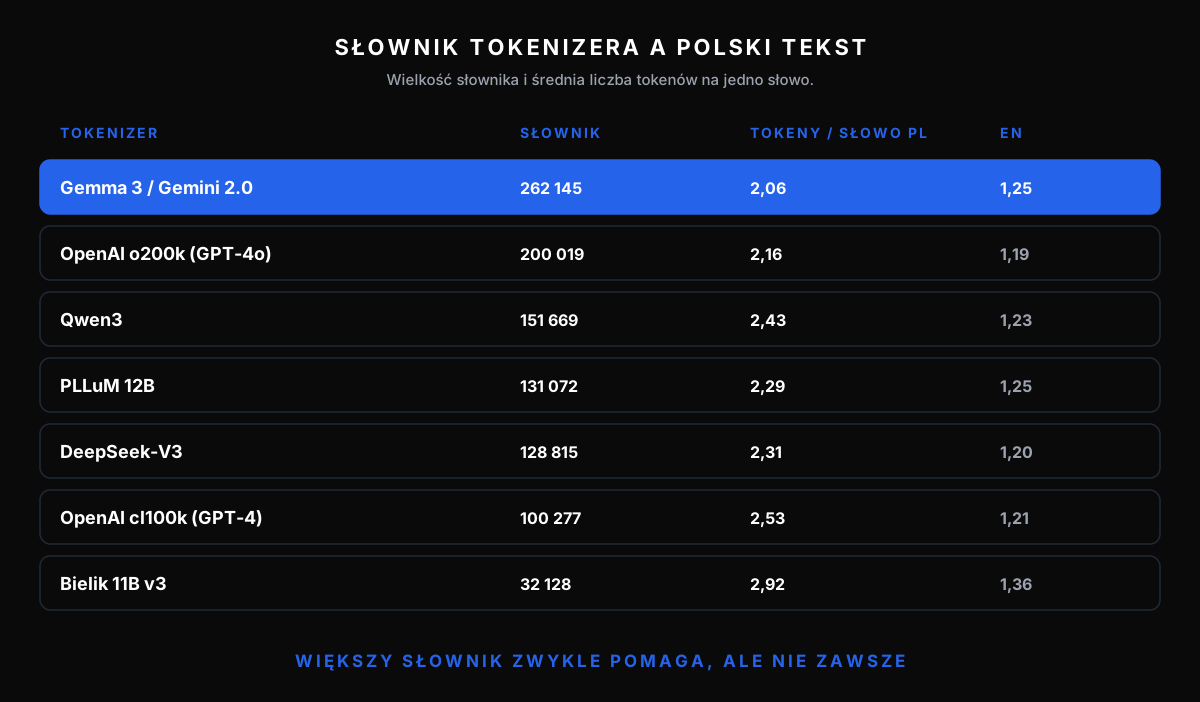
Zależność nie jest ścisła. Qwen3 ma większy słownik niż PLLuM, a zużył więcej tokenów. Liczy się również to, ile polskiego było w danych, na których uczono te modele sztucznej inteligencji. Dlatego ten sam polski tekst może kosztować w jednym modelu o 40% więcej niż w innym.
Ile Polska Firma Dopłaca za Tokeny AI?
Polska firma dopłaca za tę samą treść mniej więcej tyle, o ile więcej tokenów potrzebuje polski tekst. Przy współczynniku 1,5 z GPT-4o rachunek API, który po angielsku wyniósłby 1 000 zł, po polsku wyniesie około 1 500 zł.
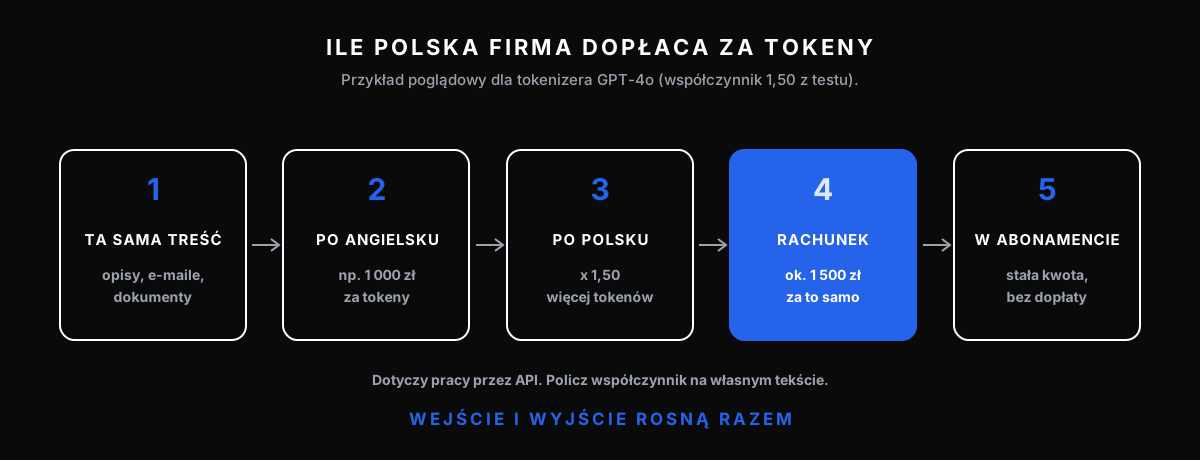
Cennik liczy osobno tokeny wejściowe i tokeny wyjściowe, a cena tokenów wyjściowych zależy od modelu, a polski zwiększa obie strony: dłuższy jest prompt, dokumenty i również odpowiedź. W ramach abonamentu ChatGPT nie płacisz za tokeny wprost. W przypadku API OpenAI przypomina, że niższa cena za milion tokenów nie musi oznaczać niższych kosztów, bo modele różnie dzielą tekst.
Ile Polskiego Tekstu Mieści Okno Kontekstu?
Okno kontekstu to limit tokenów w jednym zapytaniu. Mieści prawie o połowę mniej polskich słów niż angielskich. W tokenizerze GPT-4o 100 000 tokenów to w moim teście około 46 000 słów po polsku i 84 000 po angielsku.
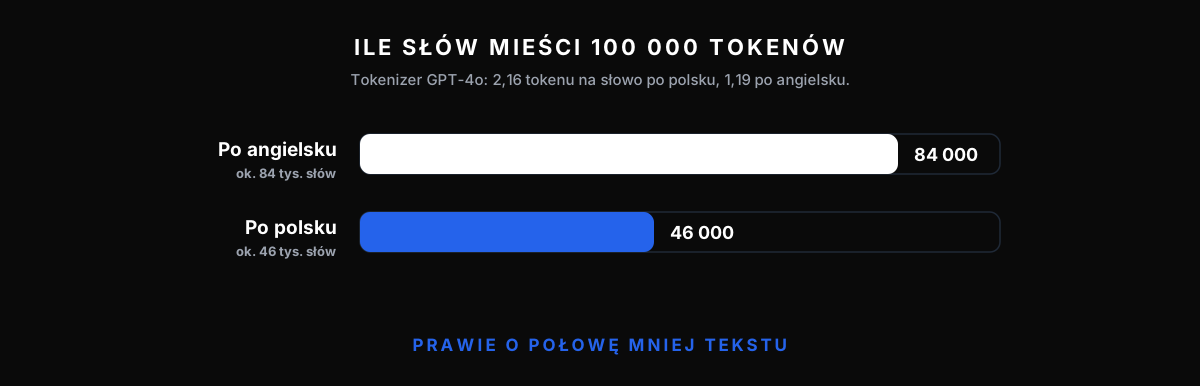
Polski potrzebował średnio 2,16 tokenu na słowo, angielski 1,19. Długa umowa czy regulamin szybciej wypełni limit modelu podczas analizy wielu dokumentów naraz.
Czy Więcej Tokenów Oznacza Gorsze Rozumienie?
Więcej tokenów nie oznacza, że model gorzej rozumie polski. Liczba tokenów mówi, ile tekst kosztuje, a nie jak dobrze model zna strukturę języka. O jakości decydują dane i dostrojenie.
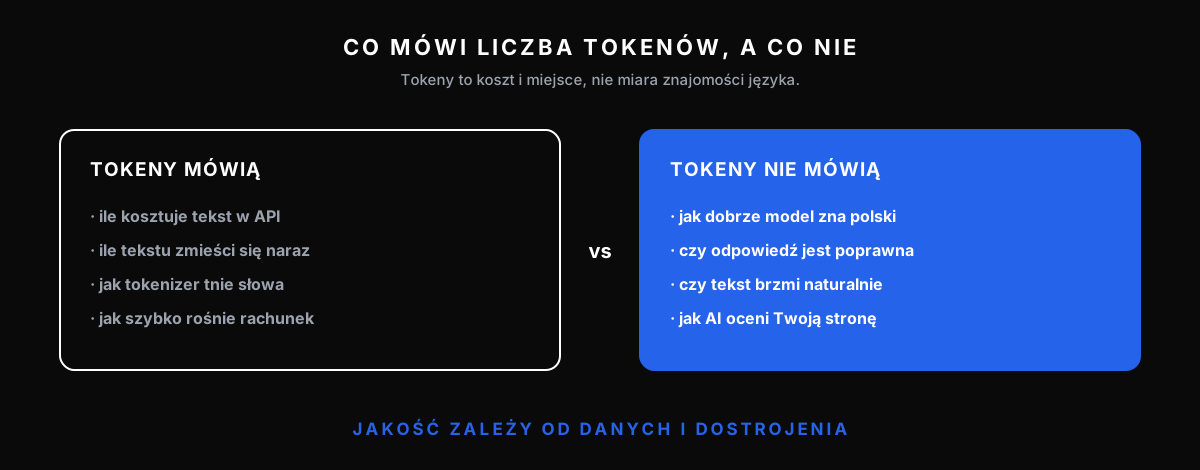
Bielik zużył najwięcej tokenów, a powstał z myślą o polskim. Tokeny mogą więc rosnąć nawet w modelu, który dobrze zna strukturę języka. Model, który czyta Twoją stronę, ocenia treść, a nie liczbę tokenów. Jak modele wybierają źródła, opisuję w tekście o tym, jak działa pozycjonowanie w LLM.
Co Firma Może Zrobić z Wiedzą o Tokenach?
Firma może policzyć tokeny na własnym tekście przed wyborem modelu i nie oszczędzać na języku tam, gdzie liczy się jakość.
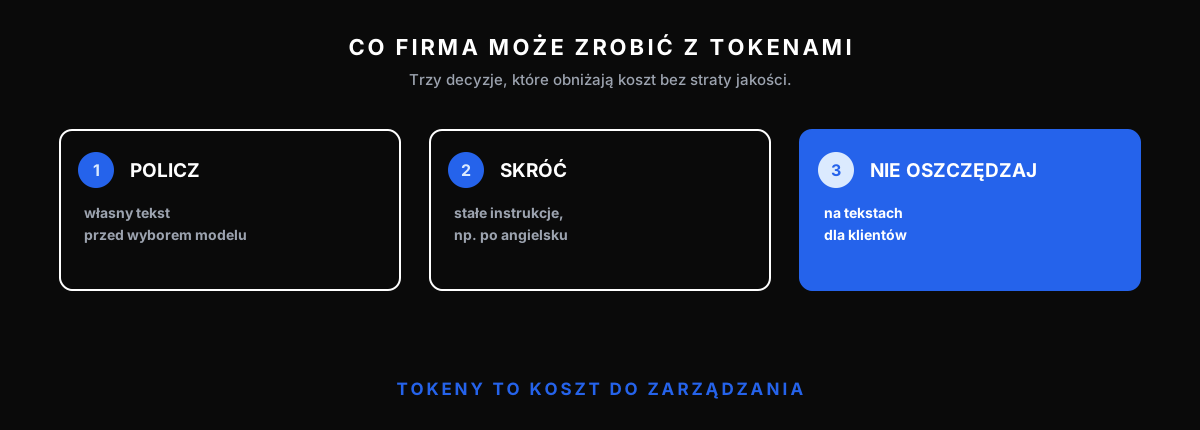
Jeśli wdrażasz narzędzia AI w firmie w celu automatyzacji tekstów, wklej typowy tekst do darmowego licznika tokenów OpenAI i porównaj z wersją angielską. Krótszy prompt to mniej tokenów, a stałe instrukcje możesz pisać po angielsku, a odpowiedź zamawiać po polsku, ale sprawdź, czy jakość nie spada. Liczba tokenów w polskim tekście nie powinna jednak decydować o języku. Teksty dla klientów muszą brzmieć naturalnie, bo klient czyta słowa, a nie tokeny.
Jak Przeprowadziłem Test?
Test objął cztery pary tekstów firmowych o tej samej treści po polsku i po angielsku: opis gabinetu, opis produktu, e-mail i klauzulę RODO. Polskie teksty mają 606 słów, angielskie 735.
Tokenizery: OpenAI o200k_base i cl100k_base (tiktoken) oraz publiczne pliki z Hugging Face dla Gemma 3, Bielika 11B v3, PLLuM 12B, Mistral Small 3.1, Qwen3 i DeepSeek-V3. Tokenizera Claude nie sprawdziłem, bo nie jest publiczny. Cztery teksty to mała próba, więc wyniki pokazują skalę różnicy, a nie dokładny koszt Twojego projektu.
Tokeny AI: Najczęstsze Pytania
Ile Tokenów Ma Jedno Polskie Słowo?
Jedno polskie słowo ma średnio od 2,06 do 2,92 tokenu, w zależności od tokenizera. W GPT-4o wyszło 2,16, a angielskie słowo zajmowało 1,19 tokenu.
Czy ChatGPT po Polsku Jest Droższy?
ChatGPT po polsku jest droższy tylko wtedy, jeśli pracujesz z AI przez API i płacisz za tokeny: około 1,5 raza więcej. W abonamencie płacisz stałą kwotę.
Który Model Zużywa Najmniej Tokenów na Polski?
Najmniej zużył tokenizer Gemma 3, używany też przez Gemini 2.0: 1,36 raza więcej niż po angielsku. Drugi był OpenAI o200k_base z wynikiem 1,50. Wynik zależy od tekstu, więc warto policzyć własny.